NVIDIA PAIR : relier plusieurs PC pour l’IA locale
PAIR donne un seul point d’accès à vos applications d’IA, découvre les machines compatibles sur votre réseau et envoie chaque requête au système approprié. Il augmente la capacité de traitement simultané, pas la VRAM d’un GPU individuel.
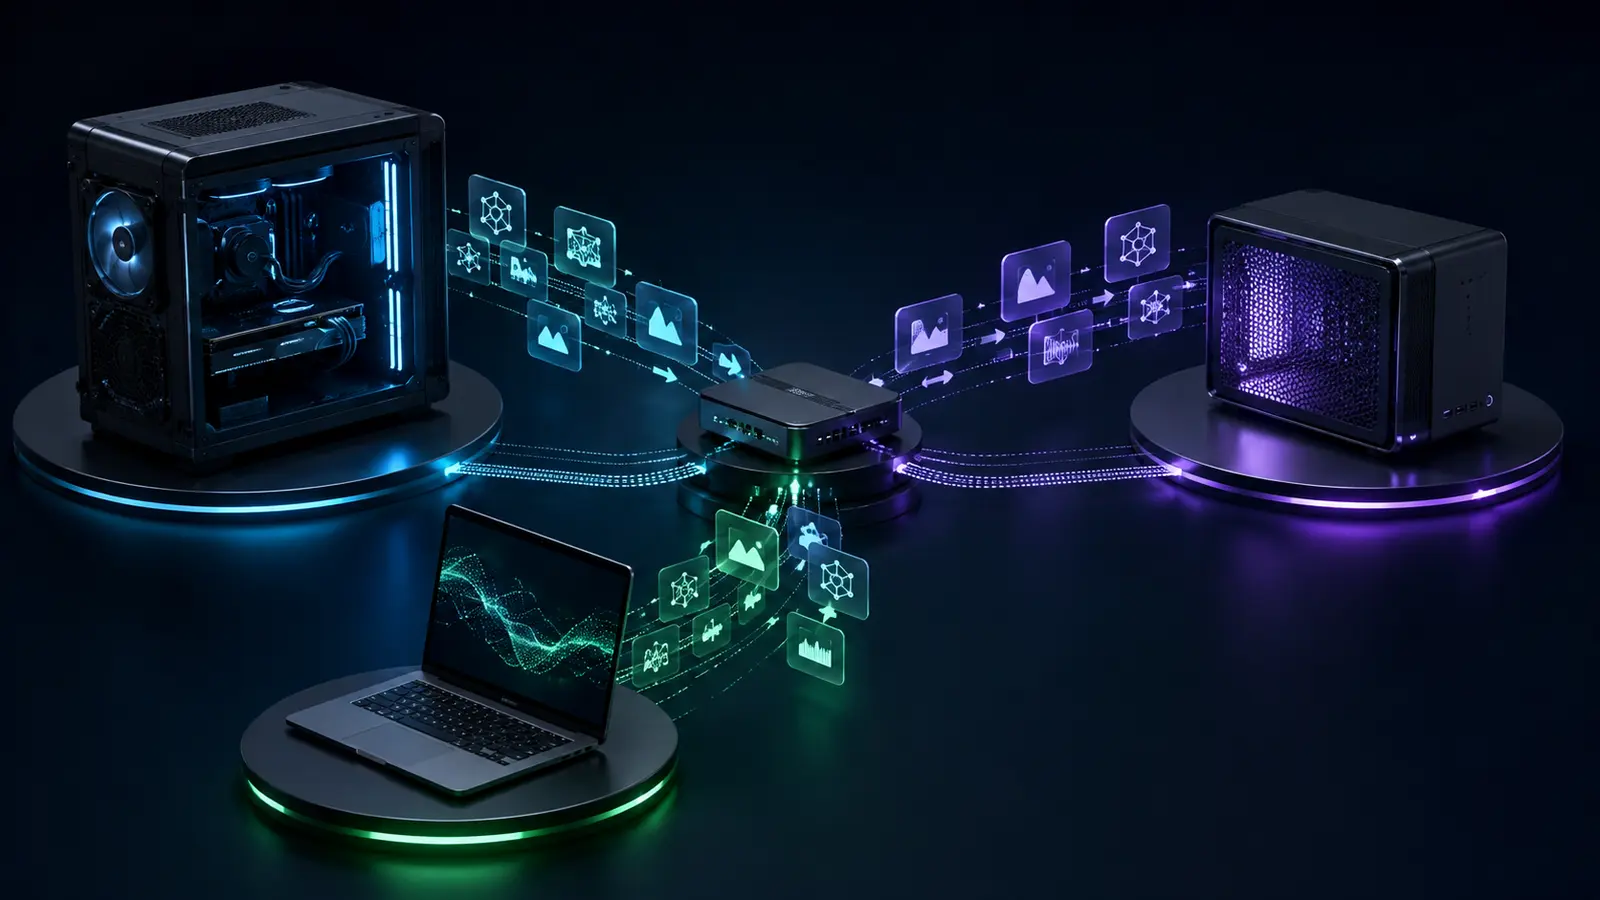
Réponse rapide : NVIDIA PAIR peut rendre un parc de PC existant plus utile pour plusieurs utilisateurs, agents ou tâches simultanées. Chaque machine reste toutefois indépendante. Un modèle doit toujours convenir à la mémoire de l’appareil qui exécute sa requête.
Mise à jour PAIR 1.0.0
La version 1.0.0 ajoute llama.cpp et la validation de RTX Spark avec llama.cpp et CUDA sous Windows on ARM. Les configurations ci-dessous remplacent les prérequis de notre article de lancement. La documentation technique confirme qu’une requête est routée vers un seul nœud : PAIR ne répartit pas un modèle entre plusieurs machines.
PAIR en une décision
| Situation | Intérêt de PAIR | Limite | Décision matérielle |
|---|---|---|---|
| Plusieurs PC compatibles déjà disponibles | Fort pour répartir des requêtes | Configuration réseau et logiciels requise | Essayez l’existant avant d’acheter |
| Plusieurs agents ou utilisateurs simultanés | Cas d’usage principal | Les tâches sont traitées par des nœuds séparés | Ajoutez un nœud seulement si la file d’attente le justifie |
| Un gros modèle dépasse la VRAM d’une seule carte | Ce n’est pas une solution de VRAM combinée | PAIR ne crée pas de GPU virtuel | Privilégiez un nœud avec assez de mémoire |
| Achat complet uniquement pour essayer PAIR | Valeur incertaine sans charge mesurée | Compatibilité des moteurs et modèles à vérifier | Ne bâtissez pas avant d’avoir testé le flux |
Comment le routage fonctionne
L’objectif est de simplifier l’accès à plusieurs moteurs d’inférence et d’utiliser les machines inactives. NVIDIA indique que les invites, les fichiers et le contexte des agents restent sur le réseau local. Cela signifie qu’ils peuvent circuler entre vos appareils locaux; cela ne veut pas dire qu’ils restent toujours sur le PC qui a lancé la requête.
PAIR n’est ni du SLI pour l’IA ni un gros GPU virtuel.
NVIDIA précise que les appareils demeurent séparés et prennent en charge des tâches parallèles. En pratique, PAIR améliore surtout le débit de plusieurs requêtes. Il ne permet pas de charger automatiquement un modèle de 30 Go en additionnant trois cartes de 12 Go.
Matériel et logiciels officiellement validés
| Élément | Configuration publiée | À comprendre |
|---|---|---|
| GPU RTX | GeForce RTX série 20 ou plus récente | La compatibilité ne garantit pas qu’un modèle donné convient à la VRAM |
| Système NVIDIA | DGX Spark / GB10 · RTX Spark | Peut agir comme nœud avec les autres appareils |
| Mac | Puce M1 ou plus récente | Un Mac peut servir de nœud aux côtés des PC RTX |
| Systèmes d’exploitation | Windows 11 · DGX OS · Ubuntu 24.04 · macOS Tahoe | Téléchargements distincts selon la plateforme et l’architecture |
| Moteurs d’inférence en 1.0.0 | Ollama · LM Studio · llama.cpp | llama.cpp est ajouté en 1.0.0 |
| Mémoire et stockage système | 4 Go de RAM ou plus; 500 Mo de disque recommandés, hors modèles | Ce sont des exigences de PAIR, pas la mémoire nécessaire à chaque modèle |
Internet n’est pas requis pour le fonctionnement local selon NVIDIA, mais il demeure nécessaire pour télécharger les modèles et les logiciels.
Pour qui PAIR est-il réellement intéressant?
Vous possédez déjà plusieurs machines compatibles, vous utilisez Ollama, LM Studio ou llama.cpp et plusieurs requêtes attendent régulièrement. Testez PAIR sur le réseau existant.
Vous avez une seule charge variable. Mesurez la taille des modèles, l’utilisation de la VRAM, la latence et la file d’attente avant d’ajouter un nœud.
Vous espérez fusionner plusieurs petites cartes pour exécuter un seul gros modèle. PAIR n’offre pas ce comportement d’après la documentation actuelle.
PAIR donne d’abord plus de valeur au matériel que vous possédez déjà.
Installez PAIR, testez votre charge et observez si les requêtes attendent. Si un nœud est constamment saturé, choisissez ensuite du matériel selon le modèle qui doit tenir dans sa mémoire, le débit visé, l’alimentation et le coût total — pas simplement parce que PAIR existe.
Planifier une configuration d’IA locale
FAQ
Qu’est-ce que NVIDIA PAIR?
NVIDIA PAIR est un routeur d’inférence IA locale en version 1.0.0. Une application utilise un seul point d’accès, puis PAIR découvre des appareils compatibles sur le réseau local et distribue les requêtes entre eux.
NVIDIA PAIR fusionne-t-il la VRAM de plusieurs GPU?
Non. NVIDIA précise que les appareils restent des systèmes séparés qui traitent des tâches en parallèle. PAIR ne crée pas un GPU virtuel et n’additionne pas la VRAM en un seul bloc.
Quels appareils sont compatibles avec NVIDIA PAIR?
Les configurations validées publiées par NVIDIA comprennent les GeForce RTX série 20 ou plus récentes, DGX Spark ou les systèmes GB10, RTX Spark et les Mac M1 ou plus récents. La liste officielle couvre Windows, Linux et macOS.
Quels moteurs d’inférence prend en charge PAIR 1.0.0?
PAIR 1.0.0 prend en charge Ollama, LM Studio et llama.cpp. Vérifiez les exigences du moteur et du modèle choisis avant l’installation.
Faut-il acheter un autre GPU pour utiliser PAIR?
Pas nécessairement. PAIR est surtout intéressant si vous possédez déjà plusieurs machines compatibles et exécutez plusieurs requêtes. Il ne transforme pas une carte trop petite pour un modèle en mémoire combinée.
Sources officielles et méthode
NVIDIA — PAIR overview, downloads and validated configurations (officiel) ↗NVIDIA — PAIR 1.0.0 release notes ↗NVIDIA — PAIR FAQ and multi-device limits (officiel) ↗NVIDIA Developer — PAIR inference-routing architecture (officiel) ↗NVIDIA — PAIR downloads ↗NVIDIA Blog — local AI announcement and availability (officiel) ↗Configurations et notes 1.0.0 revérifiées : 30 octobre 2026; sources de lancement conservées à titre historique.
Méthode : les appareils, plateformes, moteurs d’inférence et limites viennent des pages NVIDIA. La conséquence sur la capacité d’un modèle est une déduction pratique de l’architecture à nœuds séparés et est présentée comme telle. Aucun débit ou benchmark GPUStores n’est inventé.